Marcio Viegas, fundador y director general de SUST4IN
En los últimos días, además de nuevos casos de agentes de IA que extraen datos de webs de organismos públicos y de hackers que usan la IA contra bancos, descubrimos que Uber, el taxi moderno, agotó en abril su presupuesto de IA para todo 2026. ¡Cuatro meses! «Presupuestamos con lo que sabemos, pero esto cambia muy deprisa. Cada semana hay un cambio tectónico», ha reconocido su director de tecnología, Praveen Neppalli Naga.
En Amazon, un proyecto interno superó su presupuesto en un 860% porque unas tareas inacabadas siguieron trabajando en segundo plano durante cinco meses: más de un millón de dólares (unos 900.000 euros). Nadie las vigila, porque eso es precisamente lo que promete un agente de IA: trabajar solo.
Este descontrol presupuestario con la IA puede estar pasando en muchas empresas (en SUST4IN desde luego), y en departamentos de sostenibilidad, especialmente los más punteros. Mejor entender muy bien cómo estimar los costes y, por supuesto, los impactos de la IA.
En mi última tribuna, «IA, ¿niño bueno o malo?», medíamos la energía de la IA. Hoy añadimos la factura económica y las unimos por su unidad común, el token. He dividido el artículo en tres partes: cómo funcionan los tokens, cuánto cuestan y, siguiendo con el último artículo, pero ahora a nivel de token, cuánta energía y emisiones llevan detrás.
1. Cómo funcionan los tokens
Un token es un trozo de texto
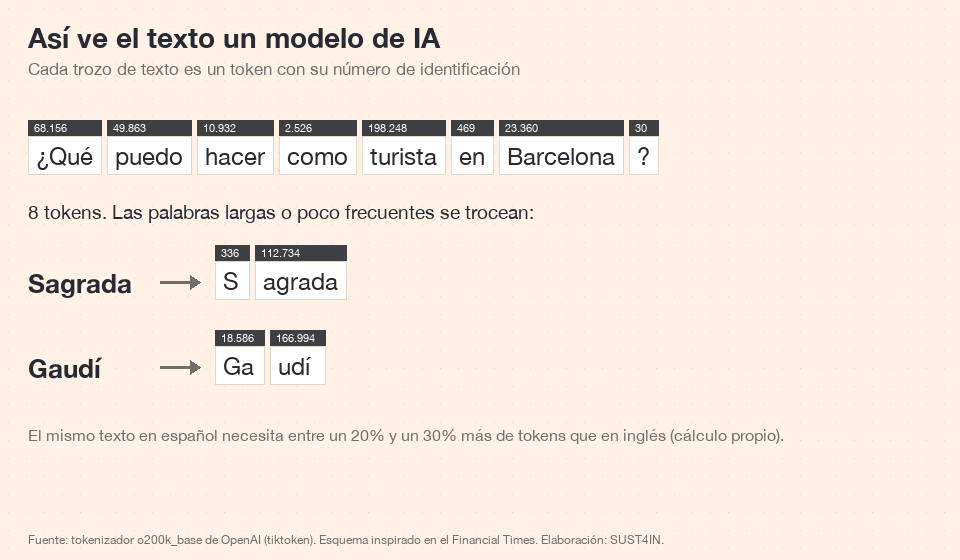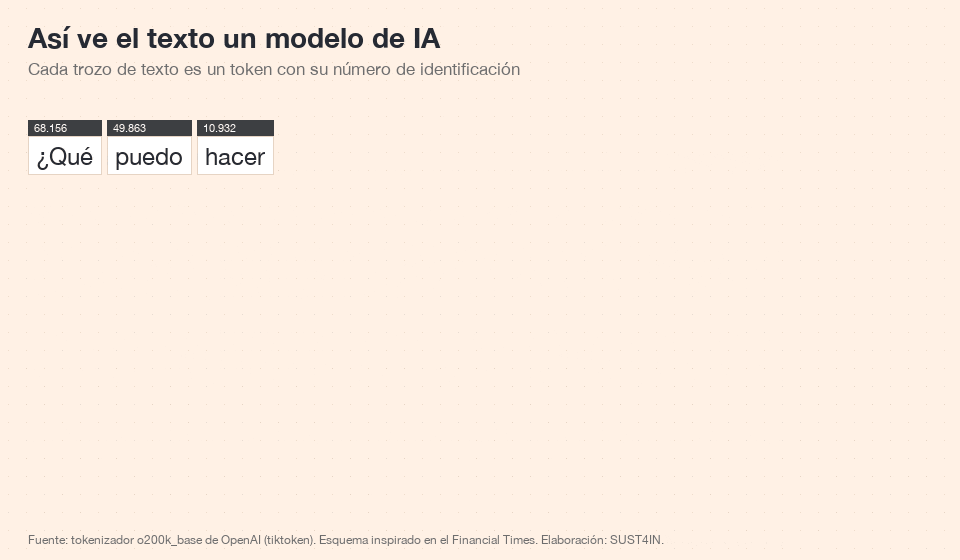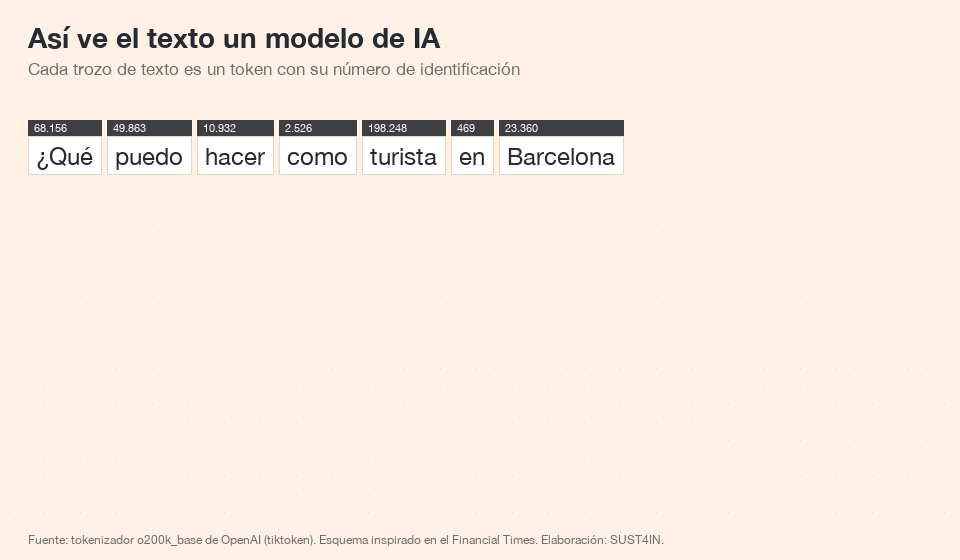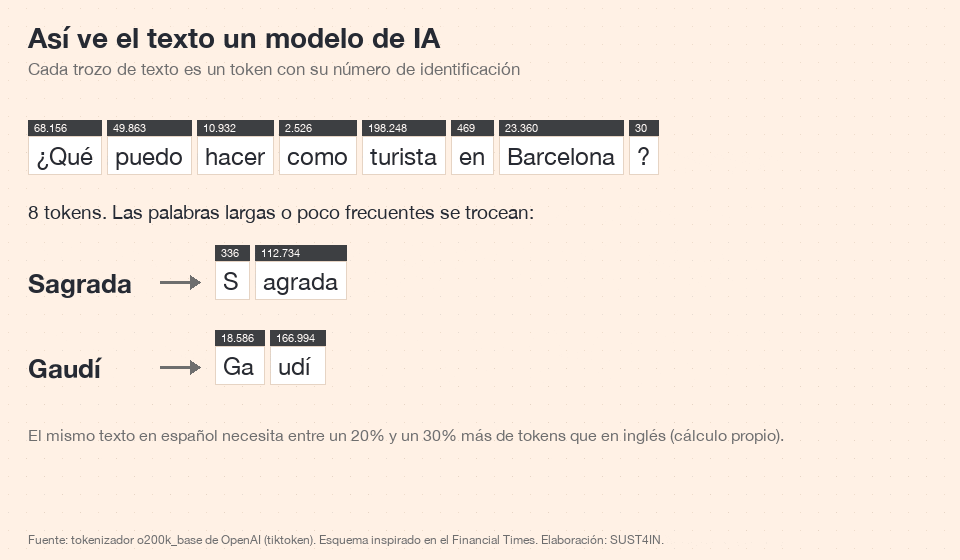
Los modelos de IA trocean lo que les escribimos en tokens: palabras enteras, fragmentos o signos, cada uno con un número de identificación. «¿Qué puedo hacer como turista en Barcelona?» son 8 tokens. «Sagrada» son dos («S» y «agrada»), y «taxímetro», tres («tax», «í» y «metro»), según el tokenizador de OpenAI.
El español paga más tokens
Cualquiera que haya tenido que encajar un texto en un informe de sostenibilidad o en un artículo sabe que, para decir lo mismo, el español necesita más palabras que el inglés.
Con los tokens pasa lo mismo, y en SUST4IN lo hemos medido con FLORES-200, el corpus que usa la literatura académica para comparar idiomas: contamos sus 2.009 frases públicas con diecisiete tokenizadores. Con el de GPT-3 (2020), el español necesitaba casi el doble de tokens (+98%); con el de GPT-4 (2023), un 55% más; con los actuales de OpenAI, Google y Meta, en torno a un 30% más.

Nuestros resultados coinciden con los que publicaron investigadores de Oxford en 2023. Como FLORES-200 es de Meta, lo hemos contrastado con dos textos independientes: la traducción oficial de la directiva CSRD (+27% con el tokenizador de GPT-4o) y las noticias que usan las universidades en la competición anual de traducción automática WMT (+20%).
La mayor parte de esa prima es inevitable: según el texto, el español es entre un 10% y un 19% más largo que el inglés, y el tokenizador «solo» añade unos 10 puntos. Por eso los tokenizadores más recientes, como Gemma 4 de Google (2026), Llama 4 de Meta o Qwen 3.5 de Alibaba, ya no bajan.
Con el mismo precio y la misma energía por token, en español pagamos y consumimos entre un 20% y un 30% más por el mismo contenido, y nos cabe hasta un 25% menos de texto en la memoria del modelo. La nota de método y los datos están a disposición de quien los pida.
Cada token nuevo relee todos los anteriores
El modelo genera la respuesta token a token, y calcula cada uno mirando todos los anteriores. Cuanto más larga es la secuencia, más cálculo exige cada paso.
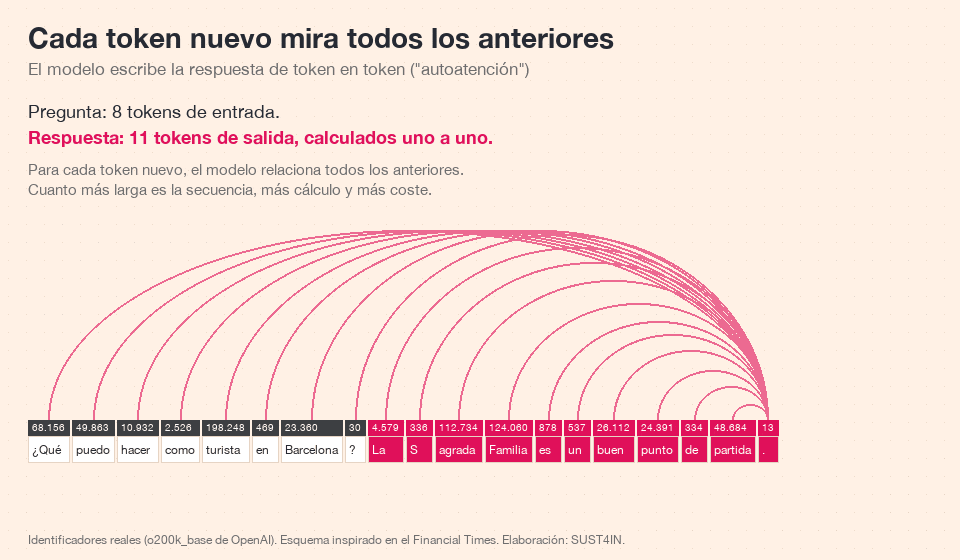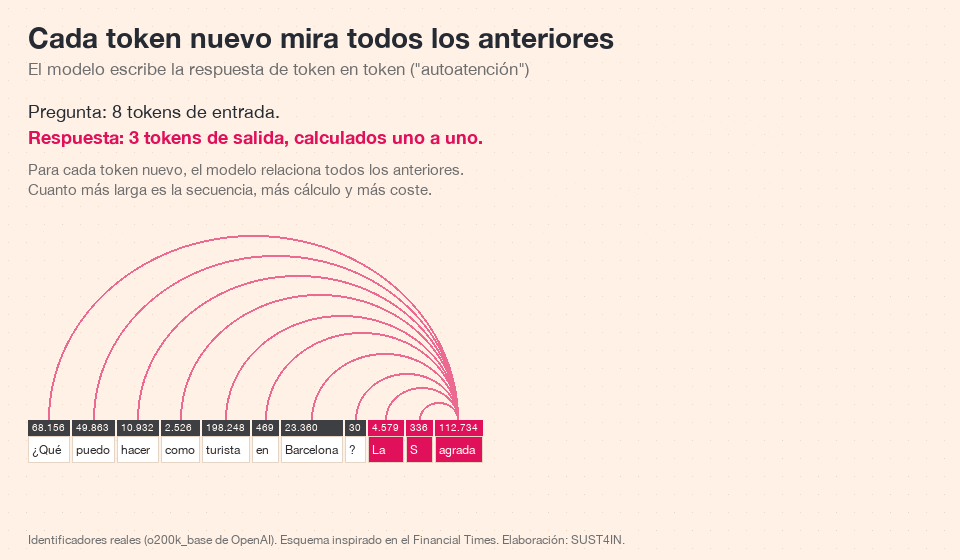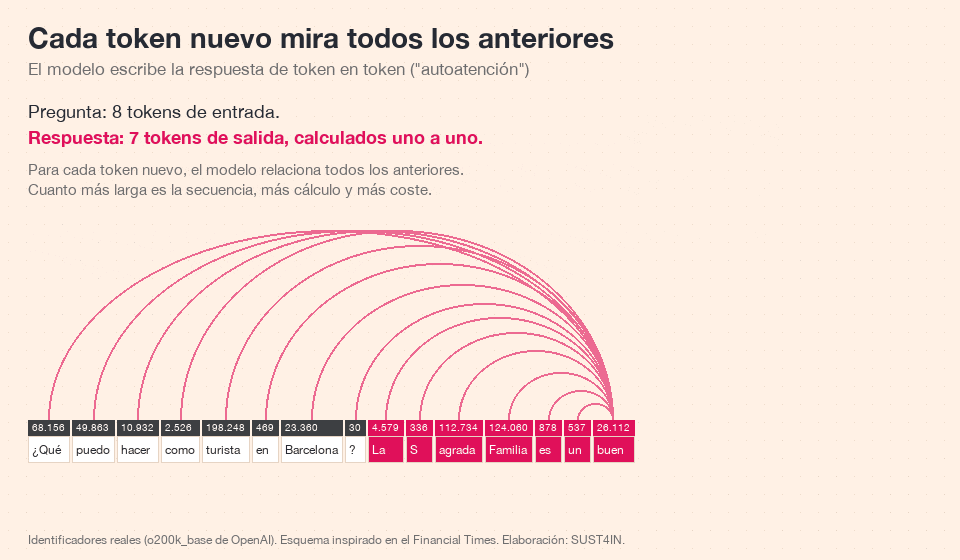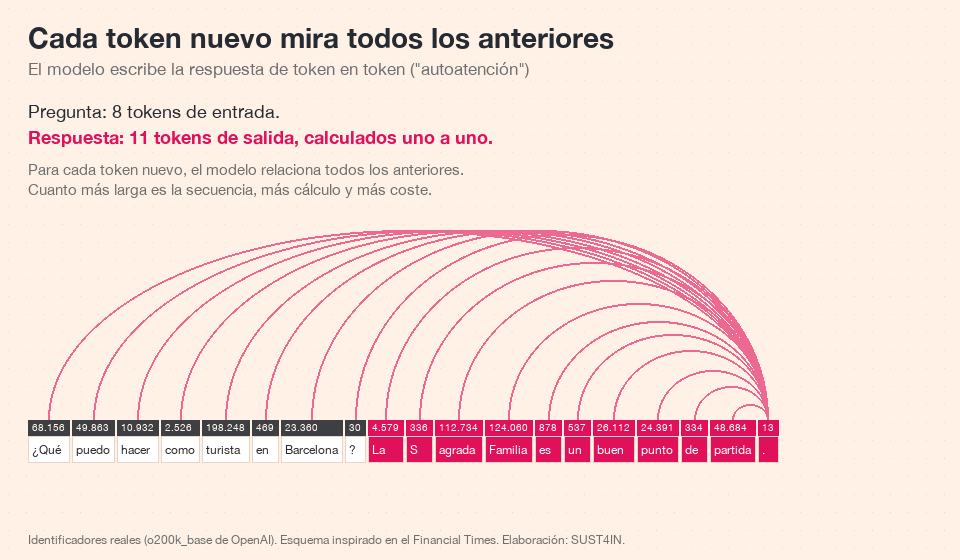
Esa memoria de trabajo, la ventana de contexto, ha pasado de 4.096 tokens en el «viejo» GPT-3.5 de 2022, unas 3.000 palabras, a un millón en la mayoría de los modelos actuales.

Fuente: Financial Times, con datos de Meibel.
Y el consumo se multiplica por diez cada año: Google procesaba 9,7 billones de tokens al mes en mayo de 2024 y 3.200 billones en mayo de 2026.

Fuente: Financial Times, con datos de Exponential View. Un «quadrillion» es un 1 seguido de 15 ceros: mil billones.
Una conversación sobre la Sagrada Familia
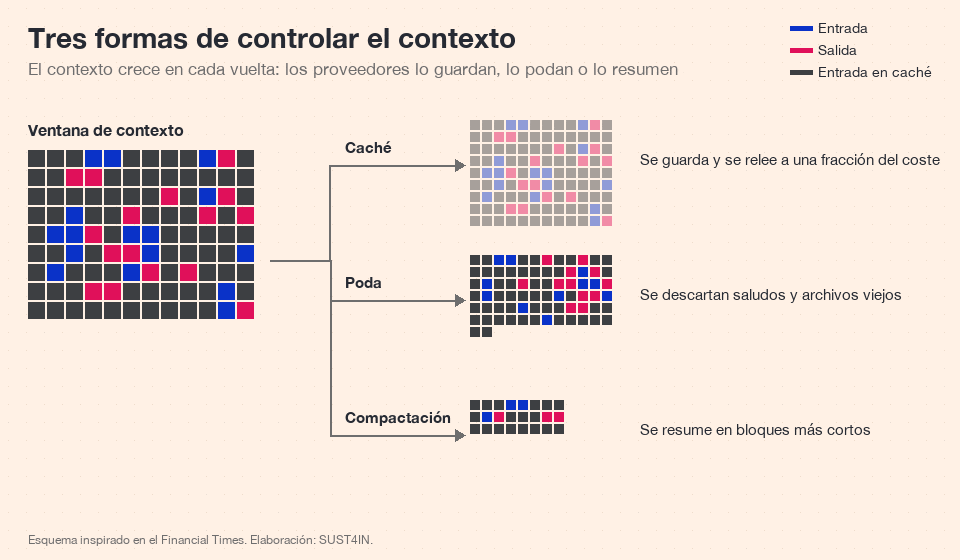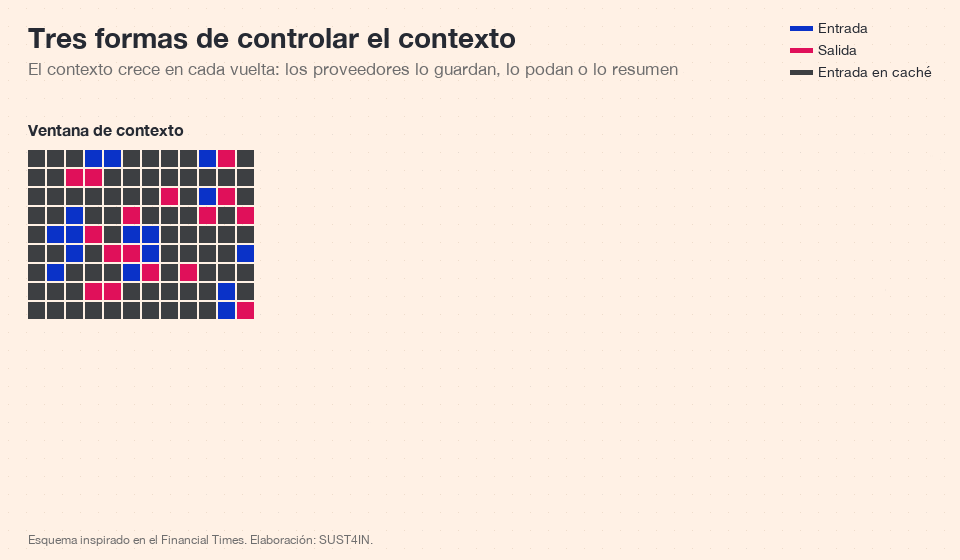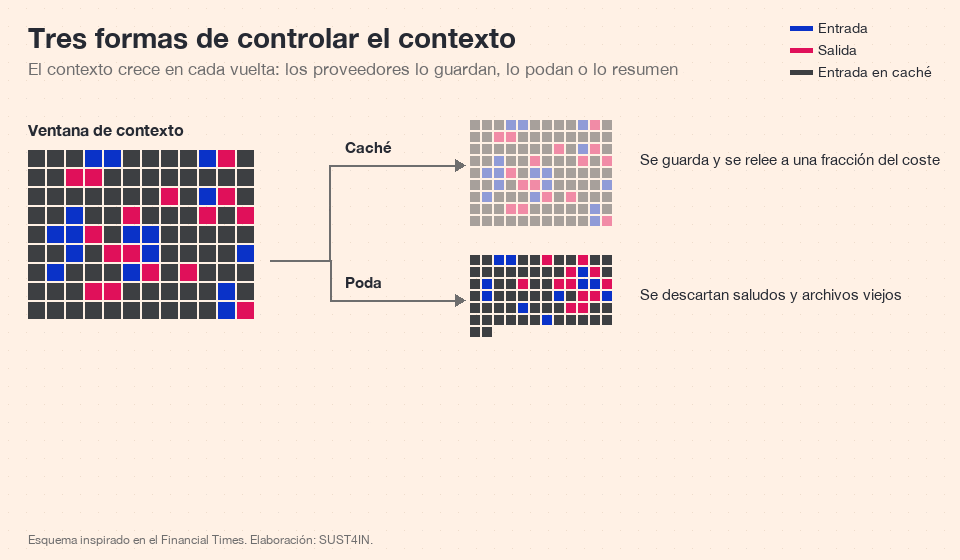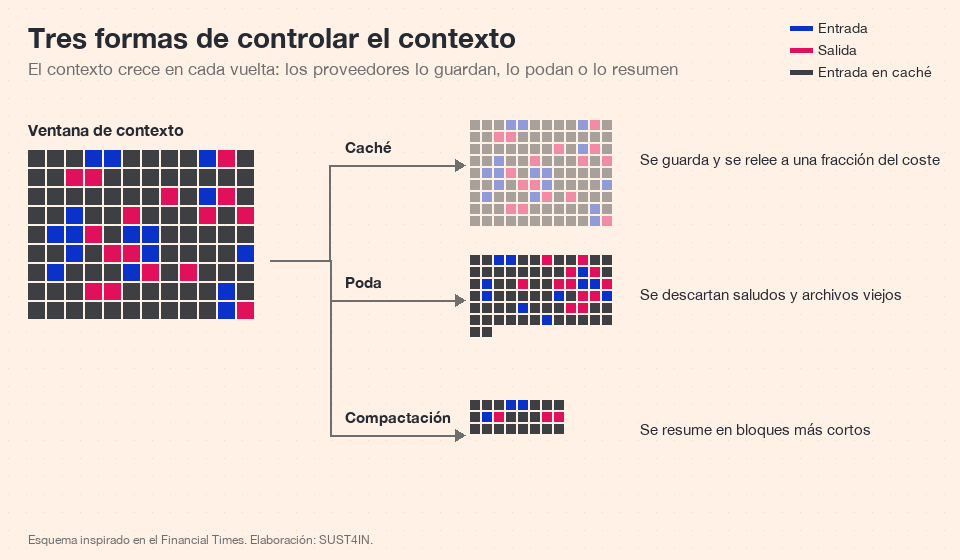
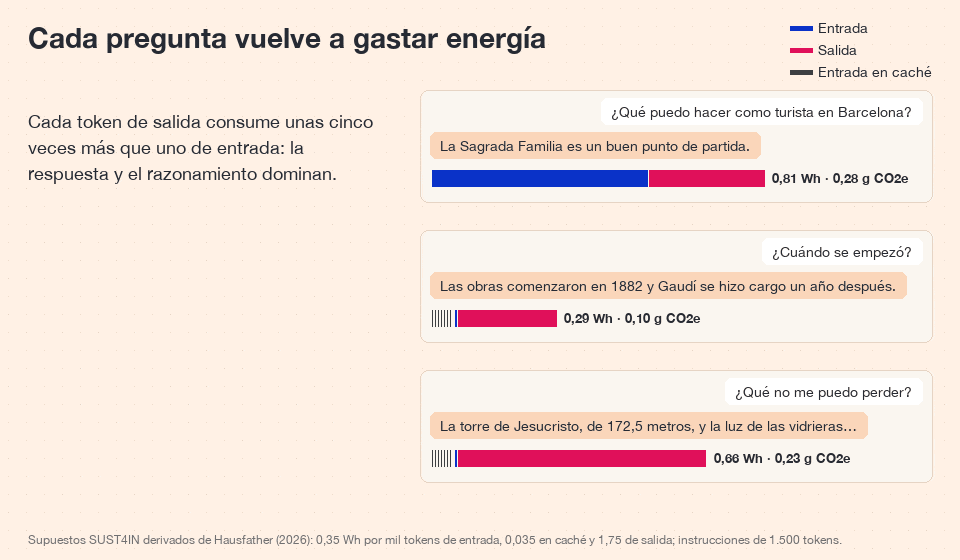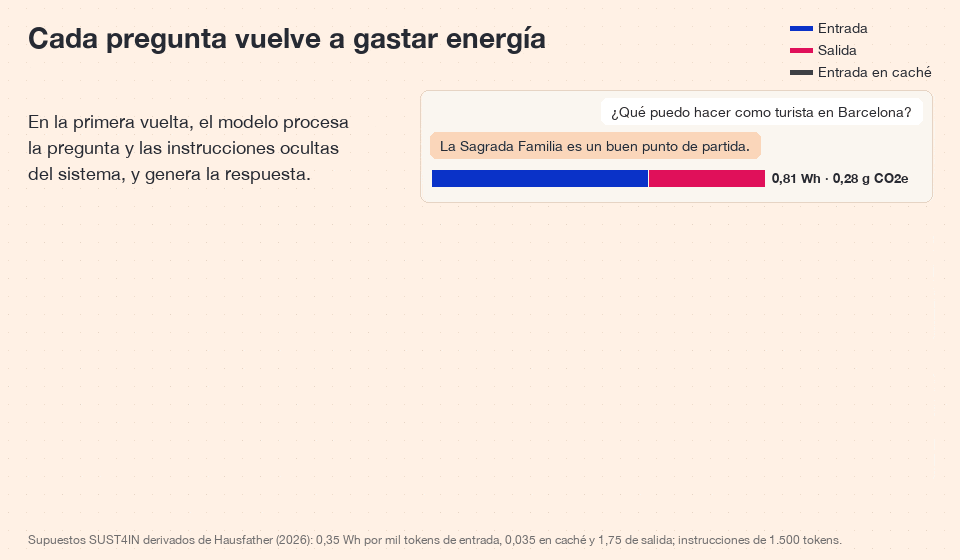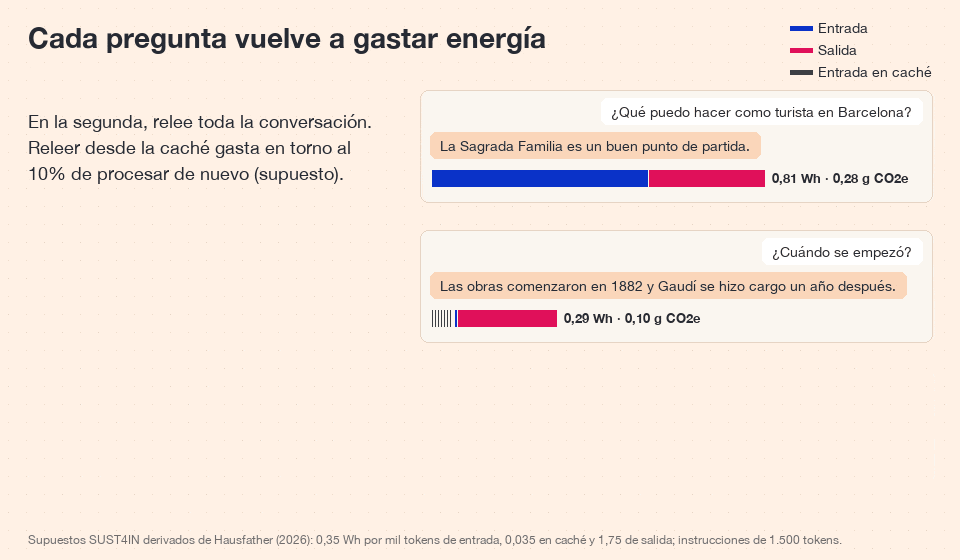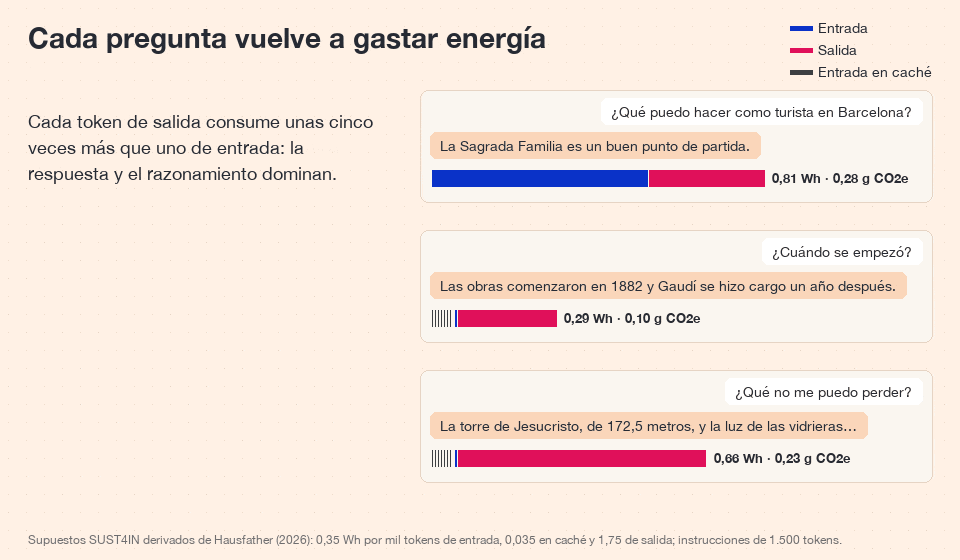
Algunos turistas ya usamos la IA como guía. Imaginaos a un turista por primera vez en Barcelona y las preguntas que ya vimos: «¿Qué puedo visitar?». «La Sagrada Familia es un buen punto de partida». «¿Cuándo se empezó?». El modelo carece de memoria propia: para saber de qué hablamos relee toda la conversación, más unas instrucciones ocultas del proveedor. Cada pregunta paga de nuevo todo lo anterior. Para contenerlo, los proveedores guardan el contexto en caché, descartan lo irrelevante o lo resumen.
Cuando el que pregunta es un agente
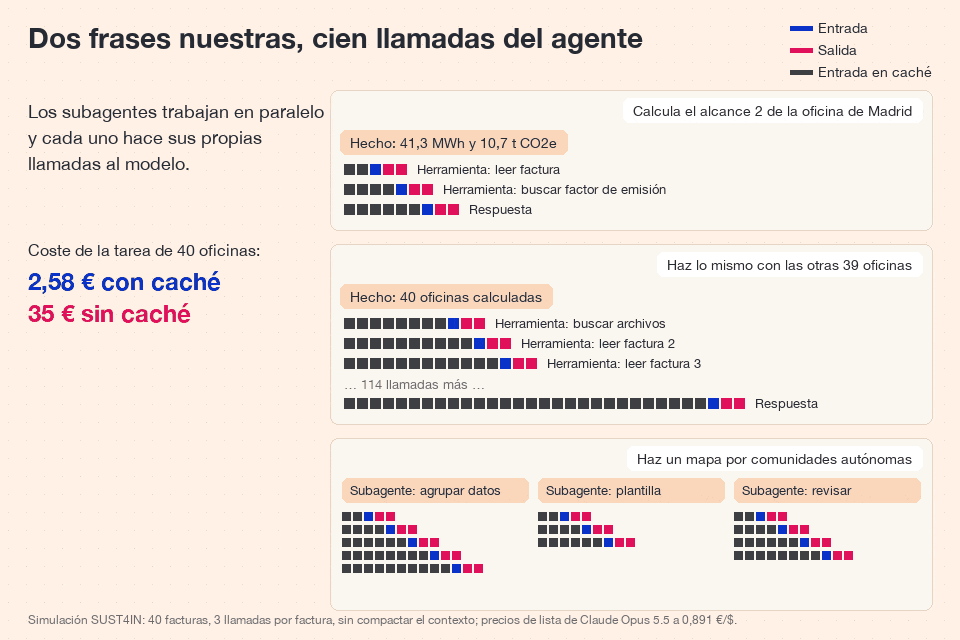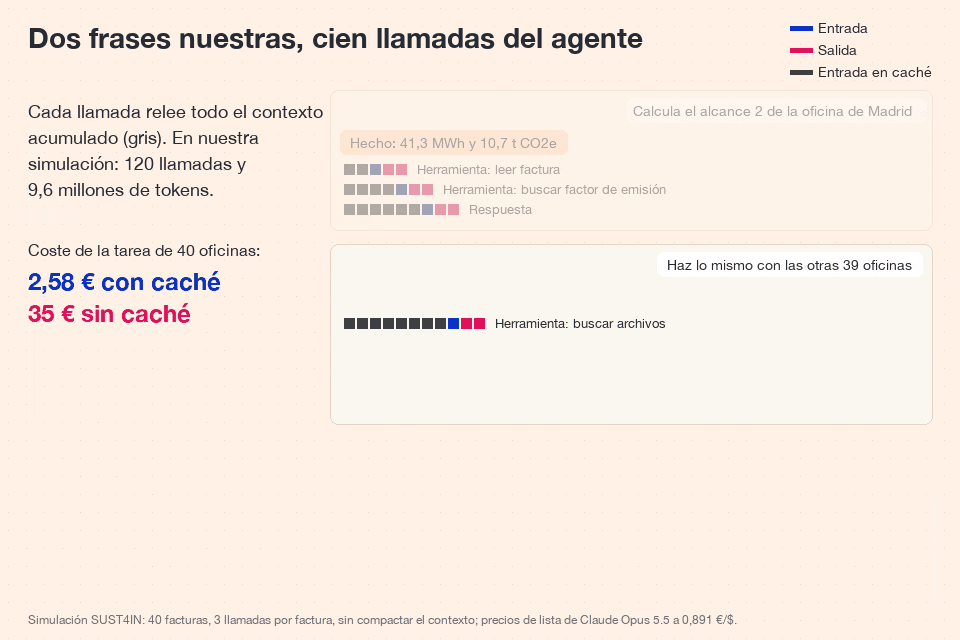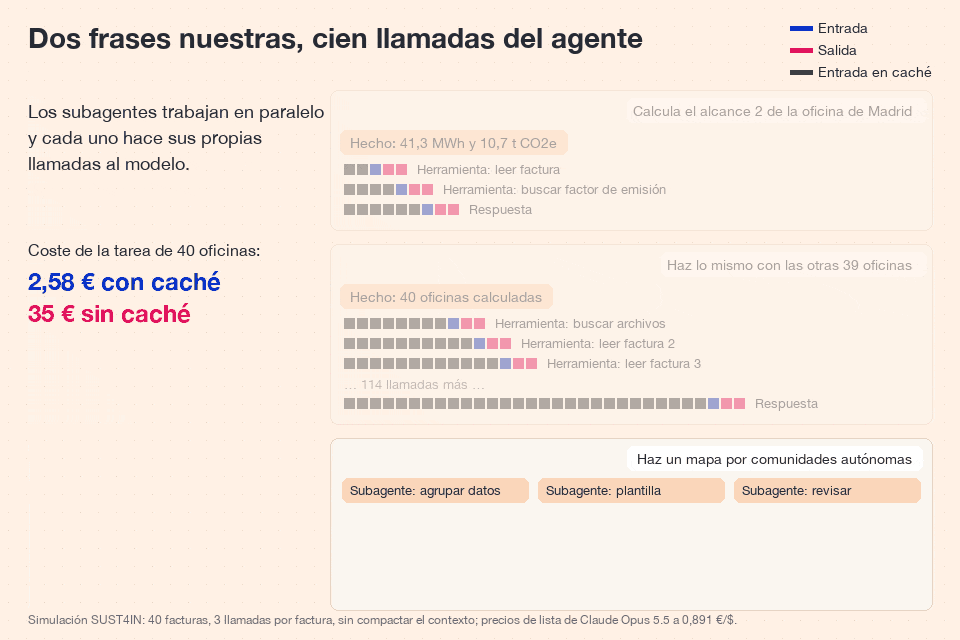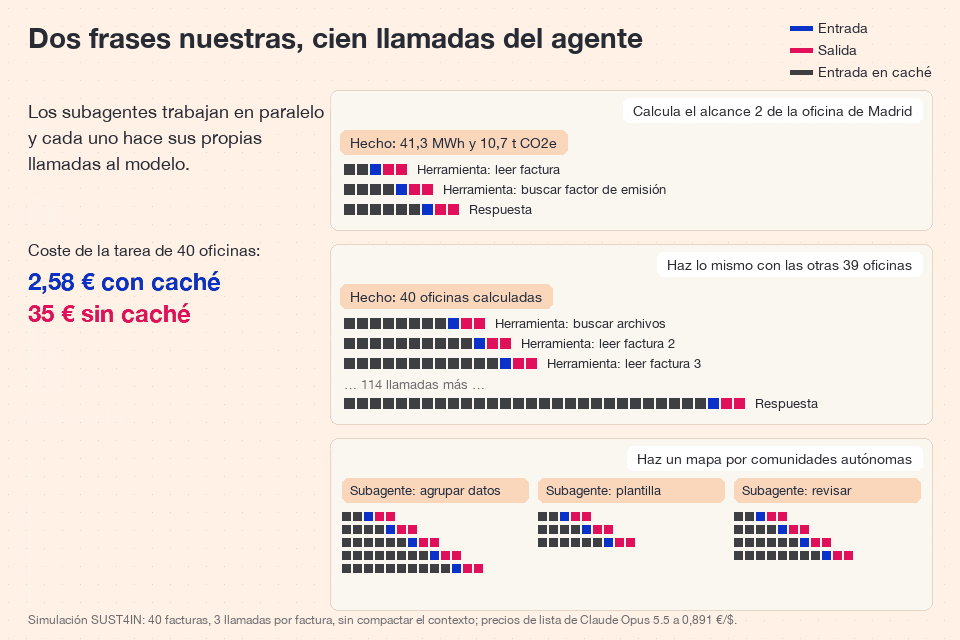
Un agente planifica, abre archivos, usa herramientas y revisa su trabajo. Cada paso es una nueva llamada al modelo con todo el contexto acumulado, sin que nadie escriba nada. Un ejemplo no demasiado complejo de nuestro oficio: calcular el alcance 2 de una empresa con las facturas eléctricas de sus 40 oficinas. Nosotros escribimos dos frases; en nuestra simulación, el agente hace 120 llamadas y procesa 9,6 millones de tokens. ¡Y eso que nuestro agente ya está bastante optimizado!
Peor aún: los agentes de programación consumen 1.000 veces más tokens que un chat sobre código, según investigadores de Stanford, el MIT, Microsoft y Google DeepMind que lo han medido, y casi todo es contexto que se relee.

Fuente: Financial Times, con datos de OpenRouter.
2. Cuánto cuestan
La factura tiene tramos, como la de la luz
| Tipo de token | Qué es | Precio en Claude Opus 5.5 |
|---|---|---|
| Entrada | La pregunta, las instrucciones y el historial que se reenvía | 4 $ por millón (3,56 €) |
| Entrada en caché | Contexto que el proveedor guarda y reutiliza | 0,20 $ por millón (0,18 €), el 5% de la entrada |
| Salida y razonamiento | La respuesta y los pasos previos que el modelo «piensa» | 20 $ por millón (17,82 €), cinco veces la entrada |
Fuente: precios de lista de Anthropic en octubre de 2026, a 0,891 € por dólar.
Como se ve, los modelos cobran cinco veces más por las salidas, sus respuestas, que por las entradas, nuestras preguntas. La razón técnica es que los tokens de salida se calculan de uno en uno y son más lentos. Queda claro que los laboratorios quieren animarnos a hacer preguntas complicadas para cobrarnos las respuestas. Y, por supuesto, el asistente te pedirá una foto de la Sagrada Familia para poder explicar su fachada.
El agente que calcula las emisiones de alcance 2 de las 40 oficinas, por ejemplo, costaría unos 2,60 € con caché y 35 € sin ella.
El índice de Silicon Data y el token, a mitad de precio
Igual que el Brent es la referencia del precio del petróleo, el nuevo índice de Silicon Data aspira a serlo del token: sigue lo que paga el mercado por un millón de tokens.
Buena noticia: el precio del token ha caído un 52,4% desde su máximo de mayo, cuando rozó los 2,07 dólares, y ha vuelto al nivel de finales de 2025.

Fuente: Financial Times, con datos de Silicon Data y Bloomberg. Dólares por millón de tokens.
Pero la historia es más complicada que el gráfico. En ese número se mezclan tres deflaciones: la técnica (producir cada token cuesta menos), la de mezcla (las empresas desvían las tareas menores a modelos abiertos y baratos) y la competitiva (una guerra de precios). El millón de tokens de los modelos de frontera ha bajado de unos 50 dólares a finales de 2023 a unos 6 (de 45 a 5 €), mientras la mediana del mercado sigue algo por debajo de un dólar desde 2024.
La misma tarea, treinta veces más cara
El mayor problema para un director financiero es la imprevisibilidad. En el estudio de Stanford, la misma tarea repetida llegó a consumir 30 veces más tokens en una ejecución que en otra (9,5 millones frente a 316.000) y a costar 16 dólares (14 €) frente a 85 céntimos de dólar (76 céntimos de euro). Gastar más tampoco garantizaba un mejor resultado. «Los agentes no están entrenados para tener conciencia del presupuesto», explica Jiaxin Pei, de la Universidad de Texas en Austin.

Fuente: Financial Times, con datos de Bai, Pei et al. (2026). Tokens y coste por tarea en 500 tareas de programación.
Uber ha respondido con un tope de unos 1.500 dólares al mes por herramienta (1.340 €), modelos más baratos para las tareas sencillas y caché. Usar el modelo más potente para todo equivale a pedir a un director que haga las fotocopias.
Del taxímetro a la tarifa fija
Hoy pagamos por la computación consumida, con independencia del valor obtenido. El taxi de Madrid ofrece la analogía. Por la ciudad se paga con taxímetro: si hay atasco en la Castellana, el taxímetro sigue corriendo y paga el cliente. Entre el aeropuerto de Barajas y el centro hay tarifa fija, y el atasco lo asume el taxista. Con los agentes, si dan vueltas, la empresa paga cada token. «Lo que importa es el precio por tarea», dijo en septiembre Greg Brockman, presidente de OpenAI, que ya prueba el pago por resultado. El asunto ya pesa en las futuras salidas a bolsa. Anthropic perdió más de 8.000 millones de dólares el año pasado (7.100 millones de euros) y ha firmado compromisos de infraestructura por 518.000 millones de dólares (461.000 millones de euros). «Si miras a 2027, nadie sabe lo que va a ganar», resume Joey Brookhart, analista de SemiAnalysis.
3. Cuánta energía y cuántas emisiones
Cada token, unos milivatios hora
«Lo más parecido a un token es un kilovatio hora», dice Aleh Tsyvinski, economista de Yale. Yo diría que más bien un milivatio hora: según nuestras cuentas, entre 0,04 y 1,75 milivatios hora por token, según el tramo. ¡El problema es que usamos millones, incluso billones, de tokens!
Como vimos en el último artículo, ningún proveedor publica la energía por token, pero Zeke Hausfather, climatólogo de Stripe, midió su propio uso de agentes: 3.200 millones de tokens y unos 170 kWh en ocho semanas. De ahí salen nuestros factores, con una incertidumbre de un factor dos:
| Tipo de token | Energía por millón de tokens | g CO2e por millón (EE. UU. / España) |
|---|---|---|
| Entrada | 0,35 kWh | 119 / 90 |
| Entrada en caché | 0,035 kWh | 12 / 9 |
| Salida | 1,75 kWh | 597 / 452 |
Cálculo SUST4IN con factores de emisión de la Agencia de Protección Ambiental de EE. UU. (341 g/kWh) y del Ministerio para la Transición Ecológica (MITECO) (258 g/kWh).
La conversación sobre la Sagrada Familia, con sus cerca de 5.200 tokens, gastaría unos 1,8 Wh, en torno a una séptima parte de lo que cuesta cargar un móvil (unos 12 Wh), y unos 600 mg de CO2e con el mix eléctrico de EE. UU. (450 mg con el español).
El agente de las 40 oficinas usa 1.800 veces más tokens y unas 230 veces más energía: unos 0,4 kWh y 140 g de CO2e; sin caché, 3,4 kWh. Todo para calcular un inventario que se mide en toneladas. Es decir, el agente es solo el mensajero: el problema son las toneladas que emitimos en otras actividades. Don’t shoot the messenger!
Token barato, como petróleo barato
En el suelo del mercado, un millón de tokens cuesta unos 0,11 dólares (10 céntimos de euro), que según el analista Jay Goldberg es «básicamente el coste de la electricidad». En los modelos más baratos, la analogía con los milivatios se vuelve literal.
Con el petróleo ya vimos qué pasa cuando un recurso se abarata. Tras el desplome del crudo de 2014, el consumo de gasolina subió en España en 2015 por primera vez desde 1998, según la Corporación de Reservas Estratégicas de Productos Petrolíferos (CORES), y en EE. UU. batió en 2016 el récord de 2007. Y eso que la gasolina es «inelástica»: una bajada del 10% apenas sube su consumo un 1% el primer año, según el metaanálisis de Tomáš Havránek y sus colegas.

Con los tokens es más difícil separar el efecto del precio sobre el consumo. El de un mismo nivel de rendimiento cae unas 13 veces al año, según Epoch AI, pero la mediana que pagan los clientes lleva dos años casi plana, y aun así el consumo se multiplica por diez. Crece sobre todo porque los modelos hacen cosas nuevas, como los agentes, y el abaratamiento lo acelera. Para el clima, el resultado se parece al del petróleo barato: más consumo total.
La deflación pesa distinto en la huella según su origen. La deflación técnica y la de mezcla reducen también la energía por token: chips más eficientes y modelos más pequeños, que gastan de 5 a 7 veces menos. La competitiva solo abarata. Si el consumo crece más deprisa de lo que baja la energía por token, las emisiones suben aunque cada token sea más limpio: la misma paradoja que Jevons vio en 1865 con el carbón.
Al petróleo lo subvencionamos, pero también lo gravamos con impuestos y derechos de emisión por parte de lo que su precio no cuenta, aunque no en todo el mundo. El token solo arrastra, como mucho, el carbono de la electricidad del centro de datos. Para una empresa, la respuesta práctica es ponerse su propio límite: un presupuesto de IA también en kilovatios hora, o un precio interno del carbono aplicado a su uso. No será mucho, con la poca información que tenemos y sin contar el «ciclo de vida» del token, pero hay que empezar a estimarlo.
La factura que no pagamos directamente: el entrenamiento
Todo lo anterior mide el uso. Sin embargo, antes hay que entrenar el modelo, y esa factura no la pagamos nosotros: la financian los inversores. Pero consume energía y emite. ¡Es el comienzo del ciclo de vida del token!
| Modelo | Entrenamiento | Fuente |
|---|---|---|
| GPT-4 (2023) | 42,4 GWh en 14 semanas: cada día de entrenamiento, lo que consumen 28.500 hogares de economías avanzadas | AIE |
| Llama 3.1 405B (2024) | 8.930 t CO2e con el criterio de ubicación (location-based); 0 t con el de mercado (market-based), porque Meta compra electricidad renovable | Meta |
OpenAI dedicó en 2024 unos 5.000 millones de dólares (4.450 millones de euros) a cálculo para investigación y entrenamiento, y 2.000 millones (1.780 millones de euros) a la inferencia, es decir, a usar el modelo para responder a sus usuarios, según Epoch AI. Con los agentes, la balanza se inclina hacia el uso. Para calcular el alcance 3, la lección es doble: un factor por token que solo cuente el uso infravalora la huella del servicio, y, especialmente en el mundo de los centros de datos, el criterio (location-based o market-based) importa, porque la misma huella de Meta, de acuerdo con sus propios datos, son 8.930 toneladas o cero.
Nuestra lectura y sugerencias
El token se ha convertido en la unidad contable de la IA, y sirve para tres cuentas a la vez: la del cálculo, la del dinero y la de la energía. En las tres, el precio unitario cae y el volumen se come la eficiencia (Jevons otra vez, perdón por la insistencia). El petróleo ya nos enseñó que un recurso barato se consume y contamina más, y el token repite la lección con un consumo que se multiplica por diez cada año.
Para una empresa española (o un departamento de sostenibilidad) que empieza con agentes, la receta es sencilla:
- presupuesto por equipo;
- modelo adecuado para cada tarea;
- medir qué se obtiene a cambio, en euros y en kilovatios hora.
Ronnie Chatterji, economista jefe de OpenAI, lo resume bien: «La idea de que todos los tokens son iguales es solo un artefacto de que podemos contarlos».
Gaudí dedicó 43 años a su obra y la dejó a medio hacer. La basílica lleva 144 años en obras, financiadas con los donativos y las entradas de millones de visitantes. Los agentes de IA trabajan bastante más rápido. Pero su presupuesto descontrolado, de momento, se parece más al de la Sagrada Familia.
PD.: Más sobre todo esto en la XIII edición del programa ejecutivo «IA aplicada a la sostenibilidad», que tendré el privilegio de dirigir del 26 al 30 de octubre, en directo por Zoom, con expertos de Befesa, Bird & Bird, Canal de Isabel II, Clarity AI, Telefónica y WWF España. Más información y matrículas aquí. Antes, el 13 de octubre, presentaré algunas ideas, aunque con menos tiempo, en esta mesa redonda organizada por FIDE.
Otras noticias
El Real Decreto español de centros de datos
La IA, incluyendo los centros de datos son una enorme e inmediata oportunidad para España, pero deben ser viables, responsables y sostenibles. En esta línea el Gobierno parece querer aprobar este mismo mes el Real Decreto que ordenará los centros de datos en España, y la polémica está servida.
El borrador parte de un diagnóstico curioso: Red Eléctrica y las distribuidoras ya han concedido a estas instalaciones más de 12 GW de acceso a la red, cuando la Estrategia de Inteligencia Artificial prevé para 2030 una demanda de entre 3,5 y 4 GW.
Los requisitos se aplican a los centros de más de 1 MW. Hasta que llegue la etiqueta europea, prevista para agosto de 2027, deberán tener una “eficacia” energética (PUE) de 1,15 (como máximo) y una “eficacia” en el uso del agua (WUE) de 0,1. Tendrán que cubrir el 80% de su consumo con renovables nuevas, puestas en servicio como máximo 18 meses antes, mediante autoconsumo o contratos a plazo, y casar consumo y generación hora a hora. Habrá también exigencias de resiliencia y soberanía digital. Incumplir sale caro: recargos en los peajes de hasta el 500% y, en los casos graves, la pérdida del acceso a la red.
Pedro Sánchez lo defendió en un artículo en Bloomberg: «cualquier aumento en la demanda de electricidad debe ir acompañado de capacidad adicional de energías renovables». Y resumió: «Nuestro objetivo debe ser comerciar en bytes, no en vatios». La patronal SpainDC responde que hay 9.000 millones de euros de inversión en juego y que tres empresas internacionales congelarán sus proyectos si el texto sale adelante. «Lo que no es negociable es que España se convierta en el país más restrictivo de Europa», dice su directora, Begoña Villacís.
Es la lógica del artículo “La IA ya se paga con taxímetro” aplicada a la red: si la electricidad sigue al alcance de quien llega primero, el consumo crecerá más deprisa que las renovables. Exigir renovable nueva y hora a hora es lo que España ya pide al hidrógeno renovable, y de hecho es lo mismo que propone la revisión en curso del alcance 2 del GHG Protocol. Veremos si el texto final mantiene el 80%.
IA Responsable: En la elaboración de esta newsletter se han utilizado herramientas de inteligencia artificial generativa (Claude y ChatGPT) como apoyo para estructuración de contenidos, redacción preliminar, revisión lingüística, síntesis documental, cálculos, gráficos y animaciones y maquetación. Todo el contenido final ha sido revisado, adaptado y validado por el equipo de SUST4IN, que asume la responsabilidad editorial sobre su exactitud y pertinencia.